模型能力
从综合智能到实际使用成本与响应体验,按八个维度了解模型能力。
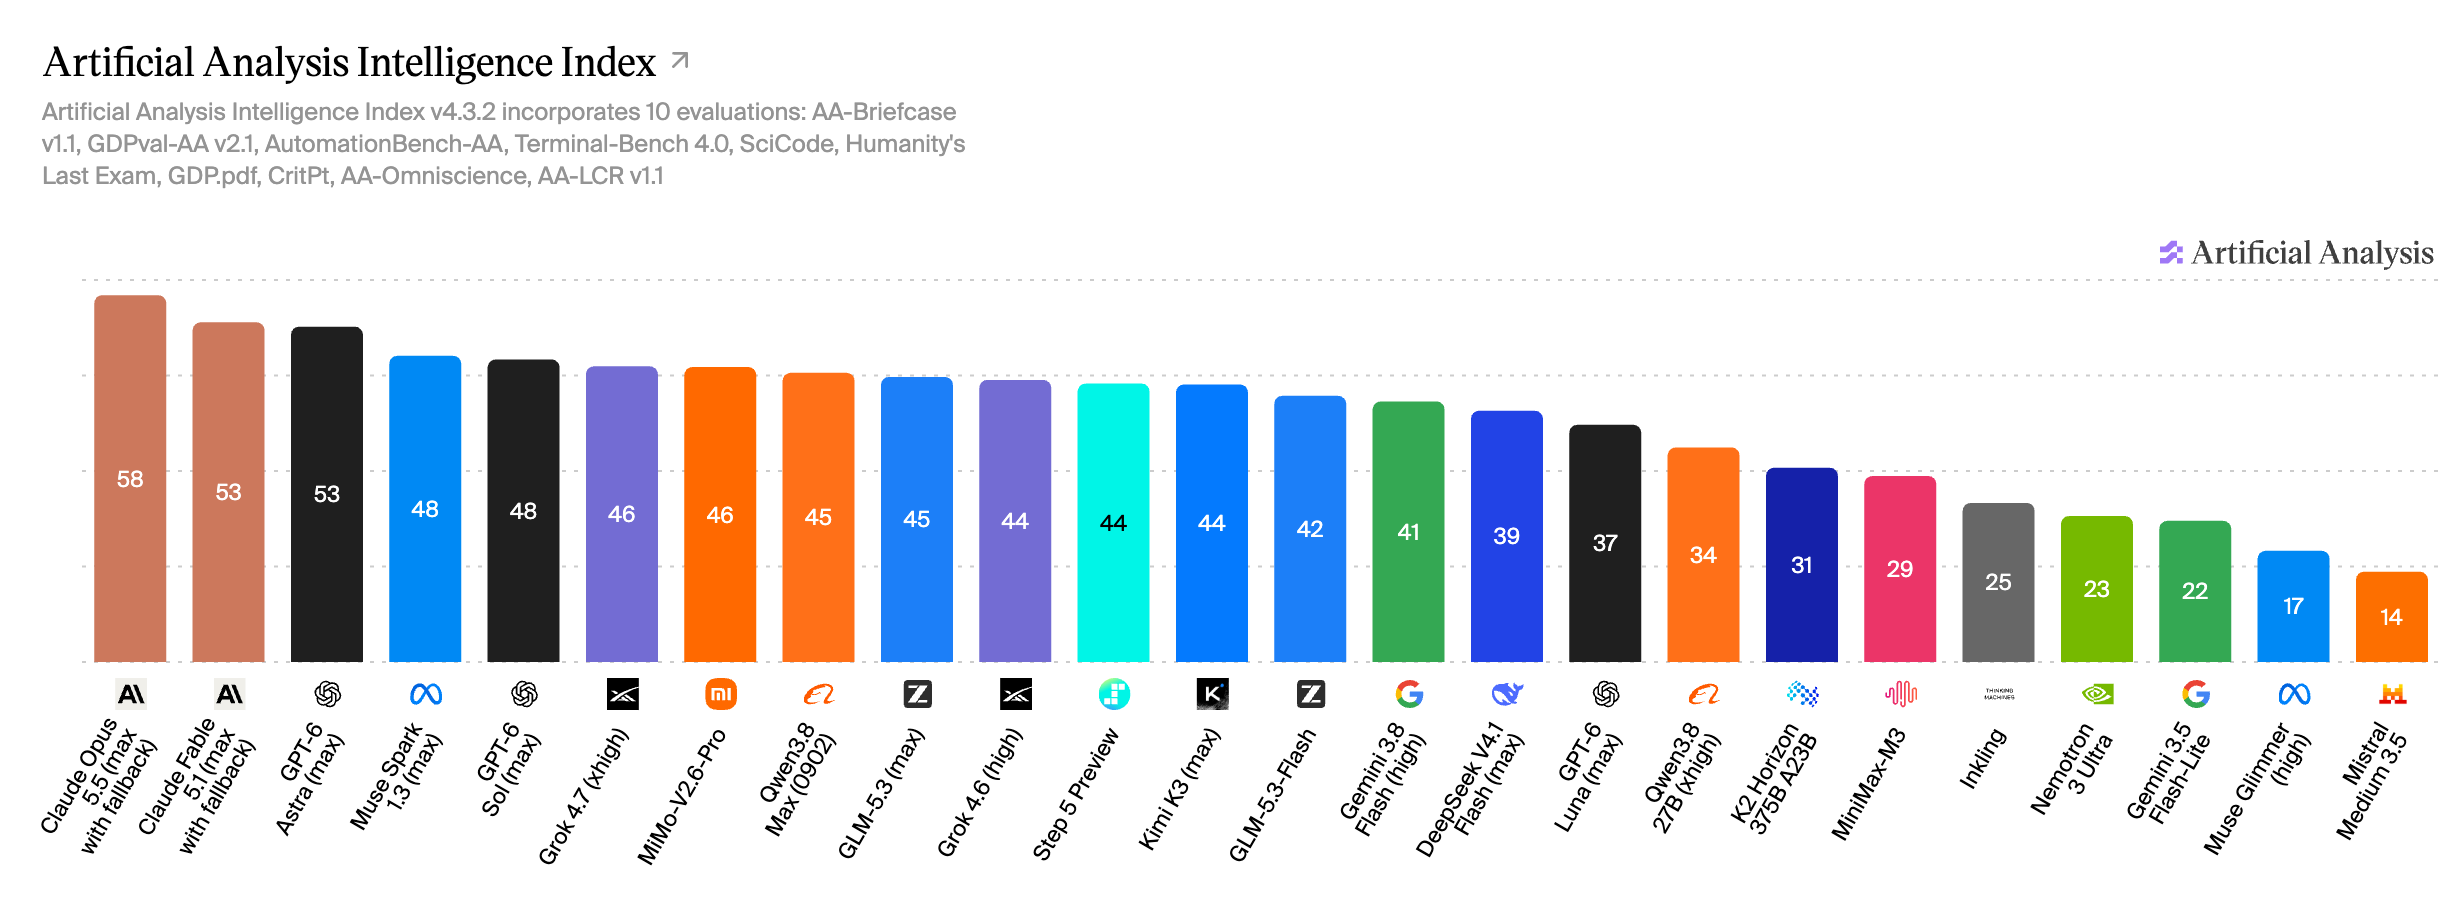
综合智能
综合比较推理、编程与知识工作能力。
图表解读
本组模型中,Opus 5.5 以 58 分领先,Fable 5.1 与 GPT-6 Astra 均取整为 53 分。比较时应保留图中推理档位。
专项能力
分别查看编程、推理、事实知识、长上下文与视觉理解表现。
展开 19 项专项评测原图19 项评测 · 独立计分
图表解读
不同任务的领先模型会变化。编程可看 Terminal-Bench 与 SciCode,长上下文推理看 AA-LCR,视觉推理看 MMMU-Pro。
Agent 工作能力
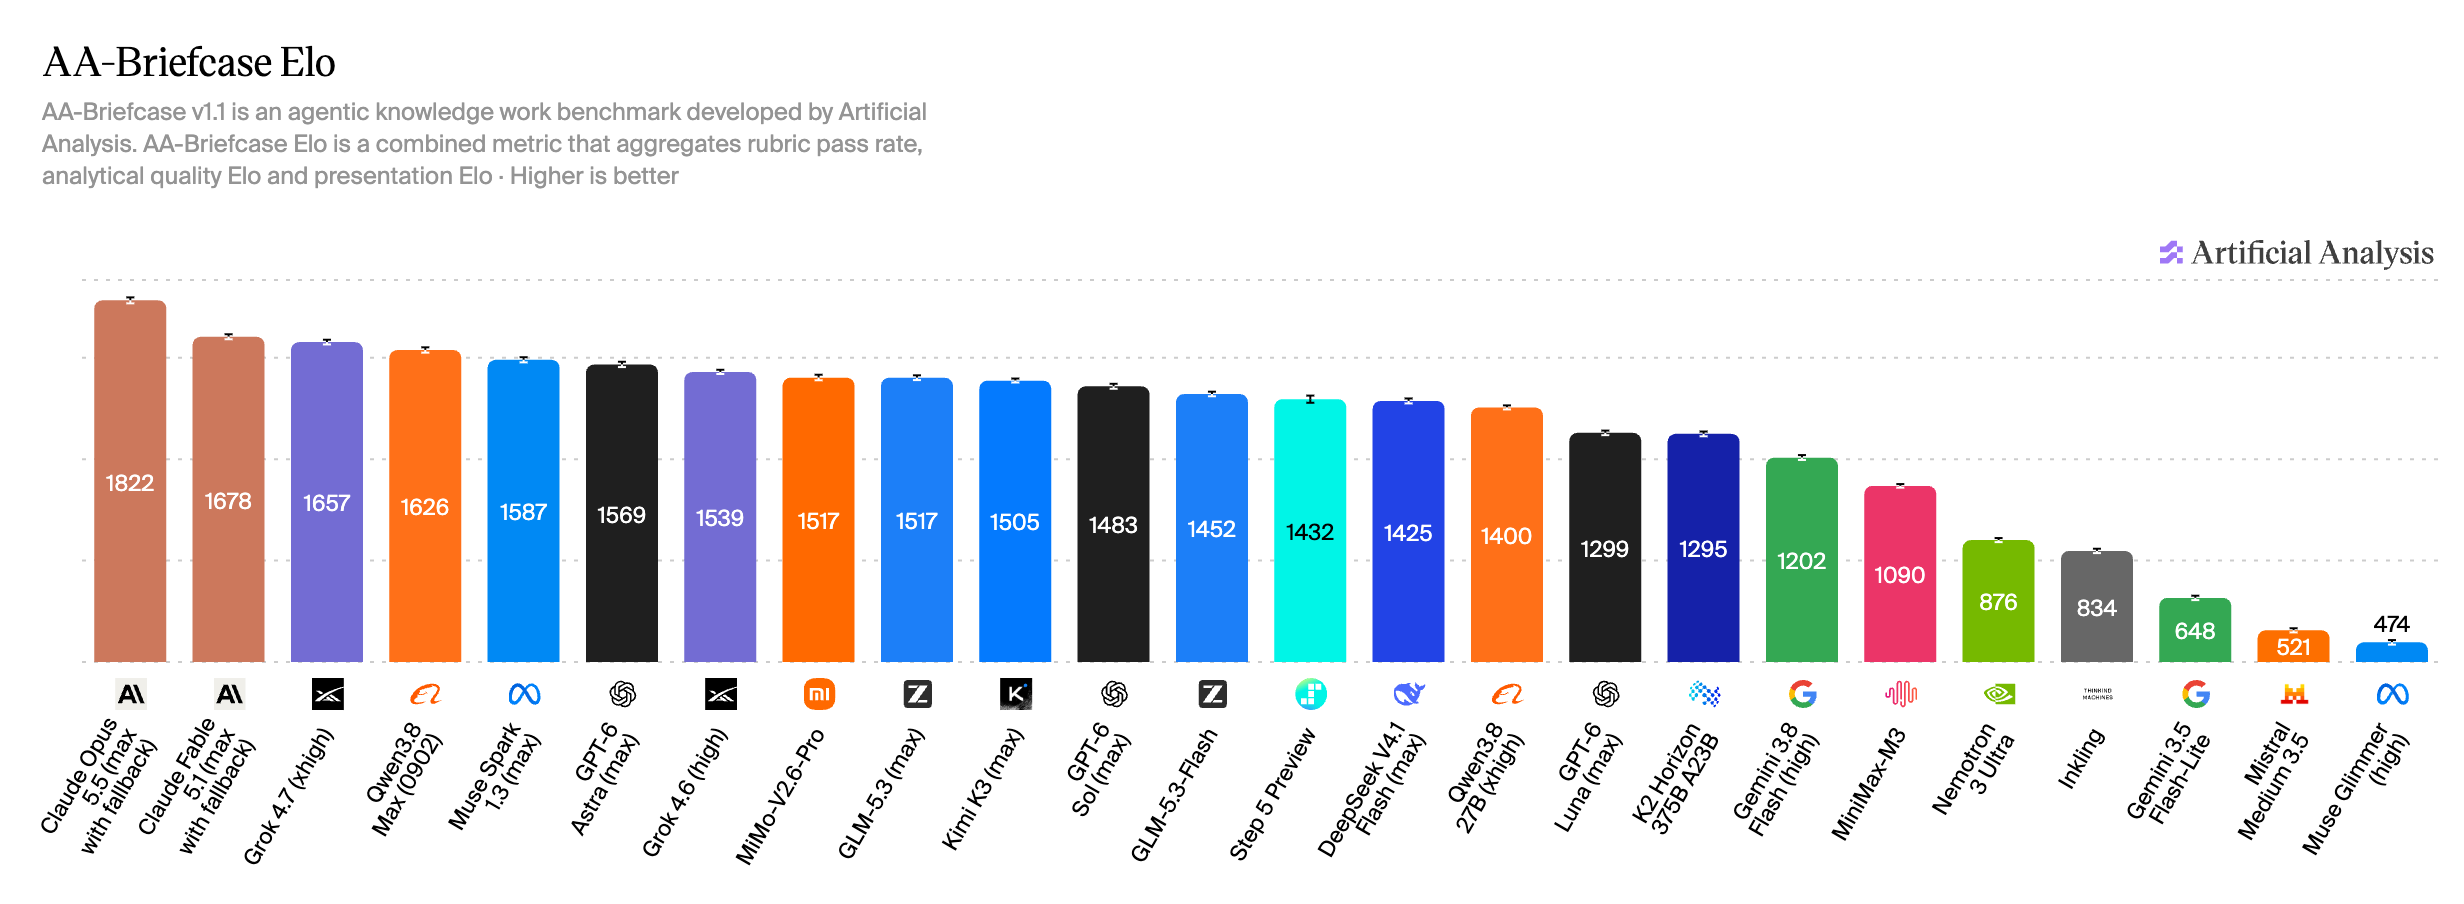
评估 Agent 能否将复杂需求转化为可用的工作成果。
图表解读
本组模型中,Opus 5.5 达到 1822 Elo,随后是 Fable 5.1 的 1678 和 Grok 4.7 的 1657。
能力与成本
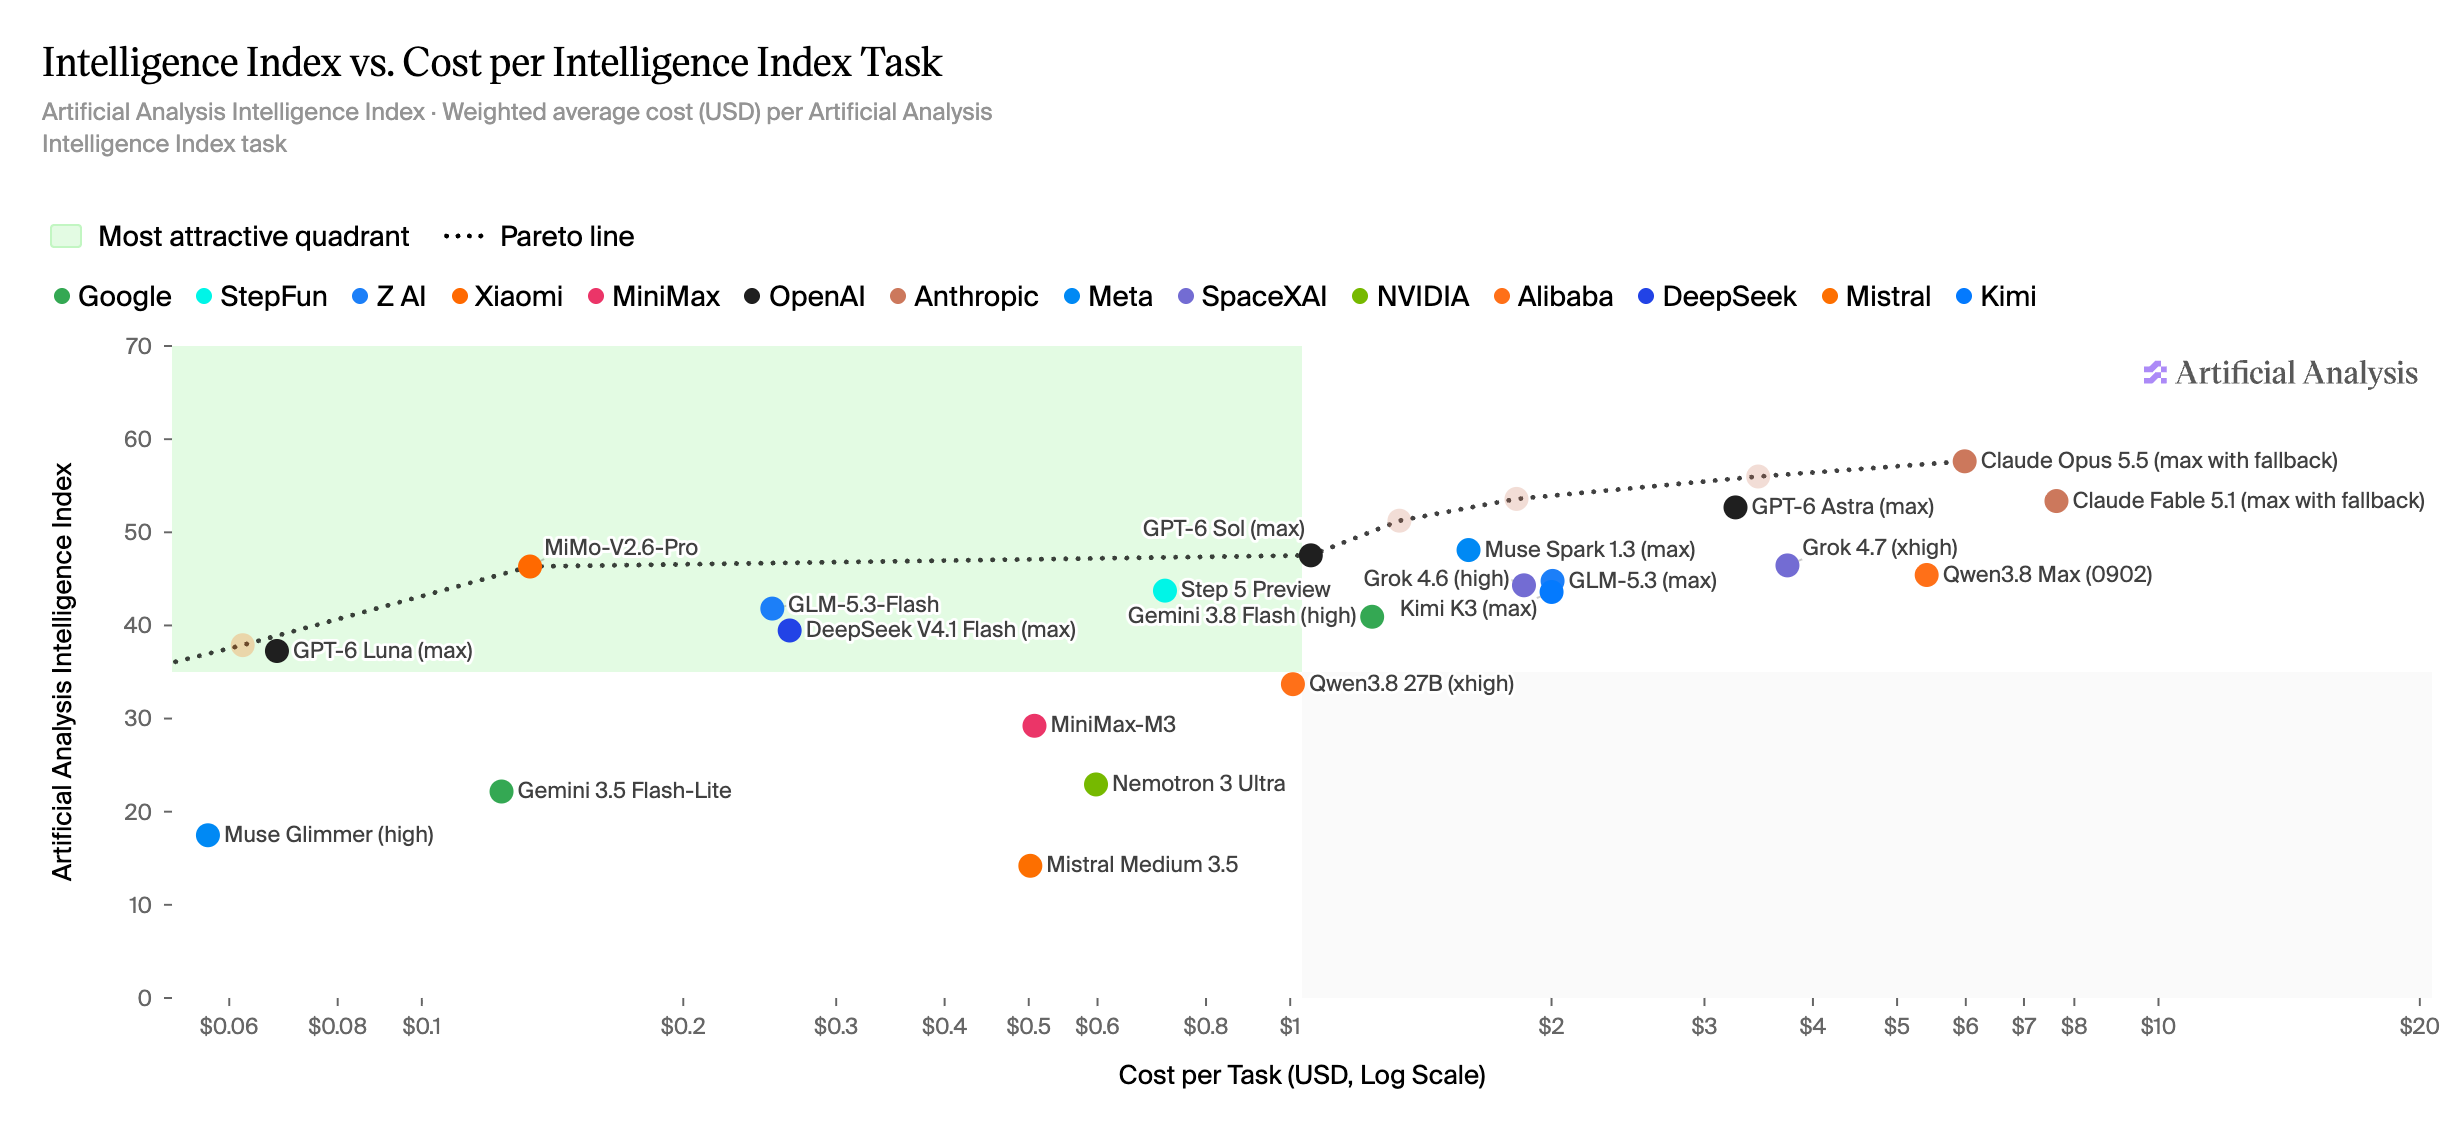
在所需能力与单任务成本之间找到合适平衡。
图表解读
越靠近左上方,能力越强、成本越低。虚线前沿帮助识别这组模型中兼顾能力与成本的选择。
Token 效率
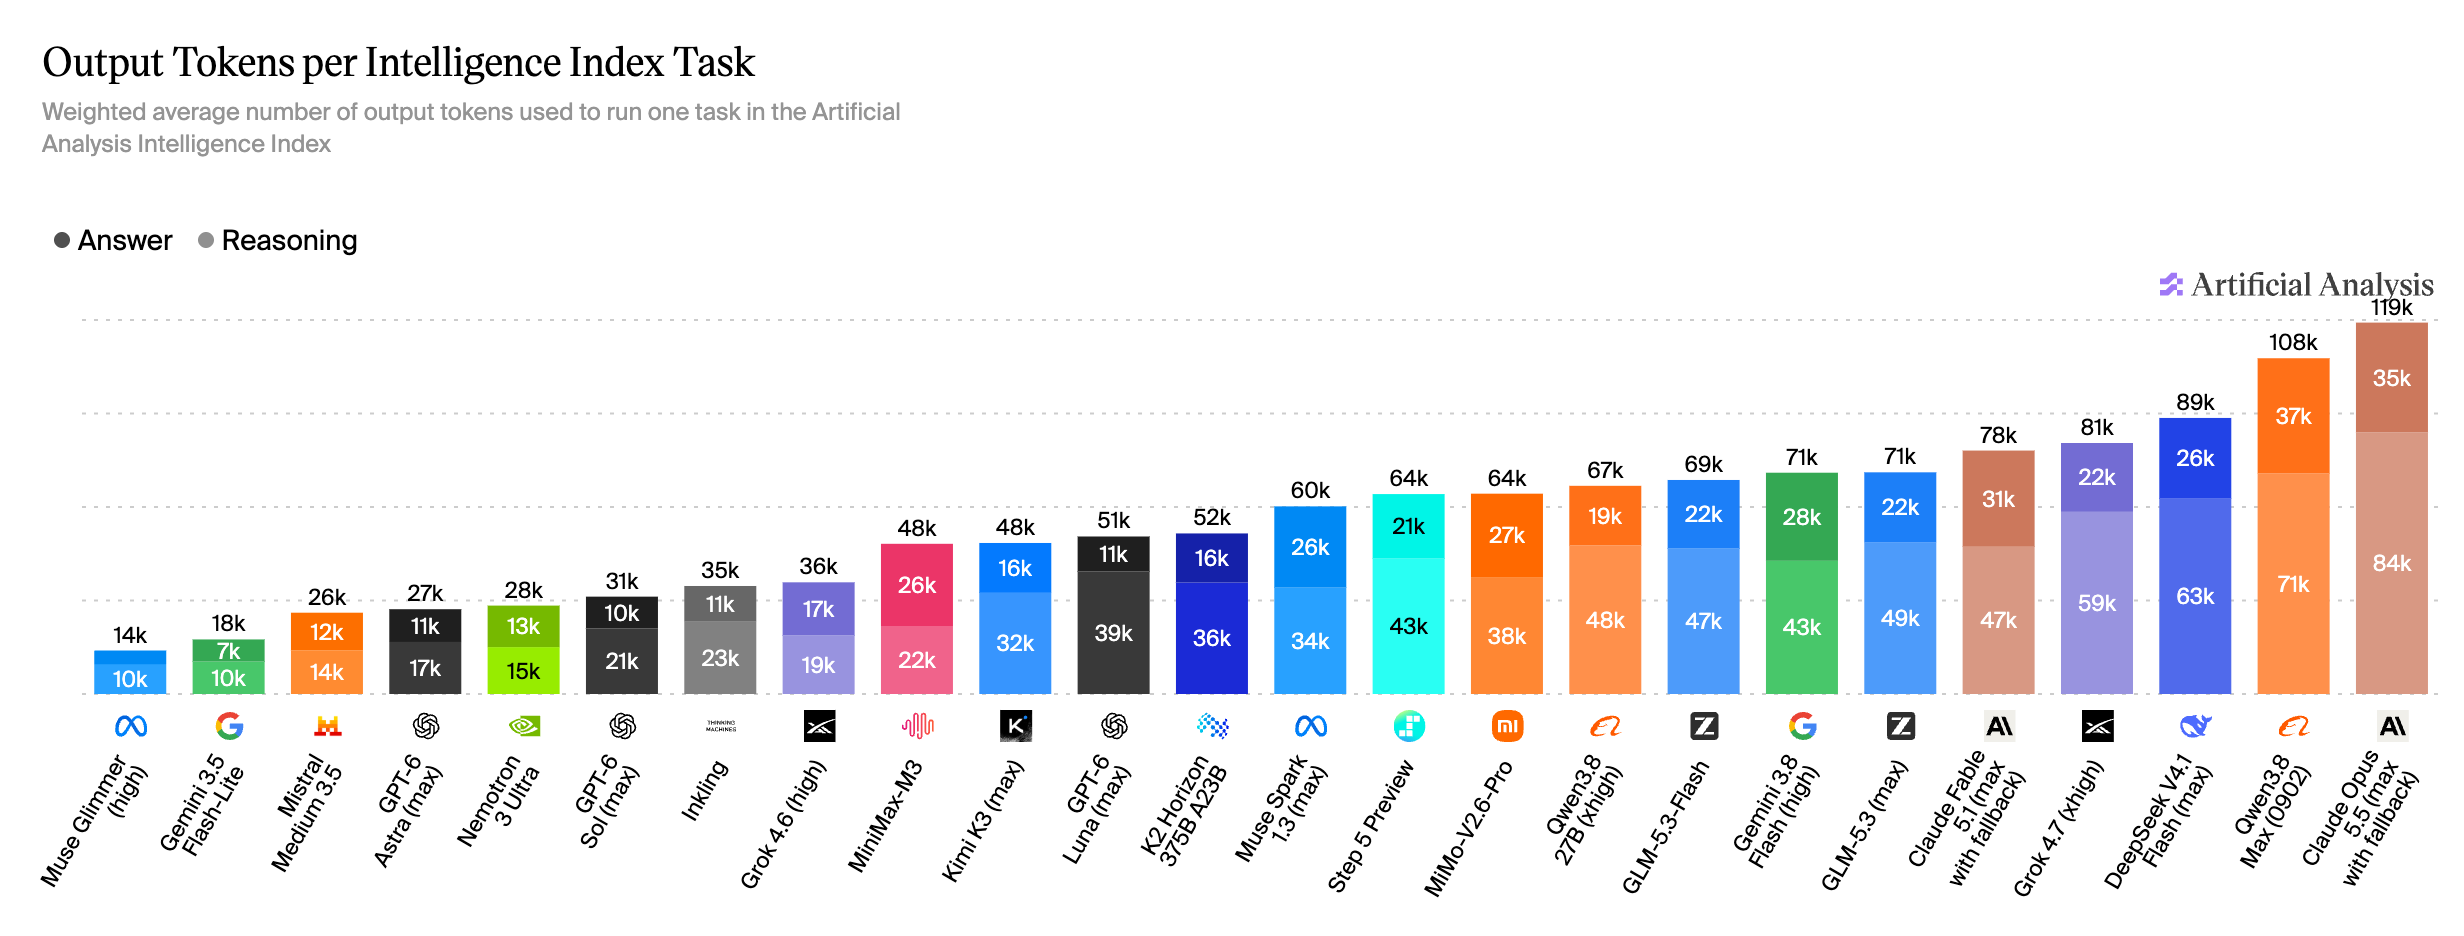
观察完成一次评测任务需要多少推理和答案 Token。
图表解读
Opus 5.5 每任务约输出 119k Token,GPT-6 Sol 约为 31k;推理 Token 占据了较大比例。
上下文容量
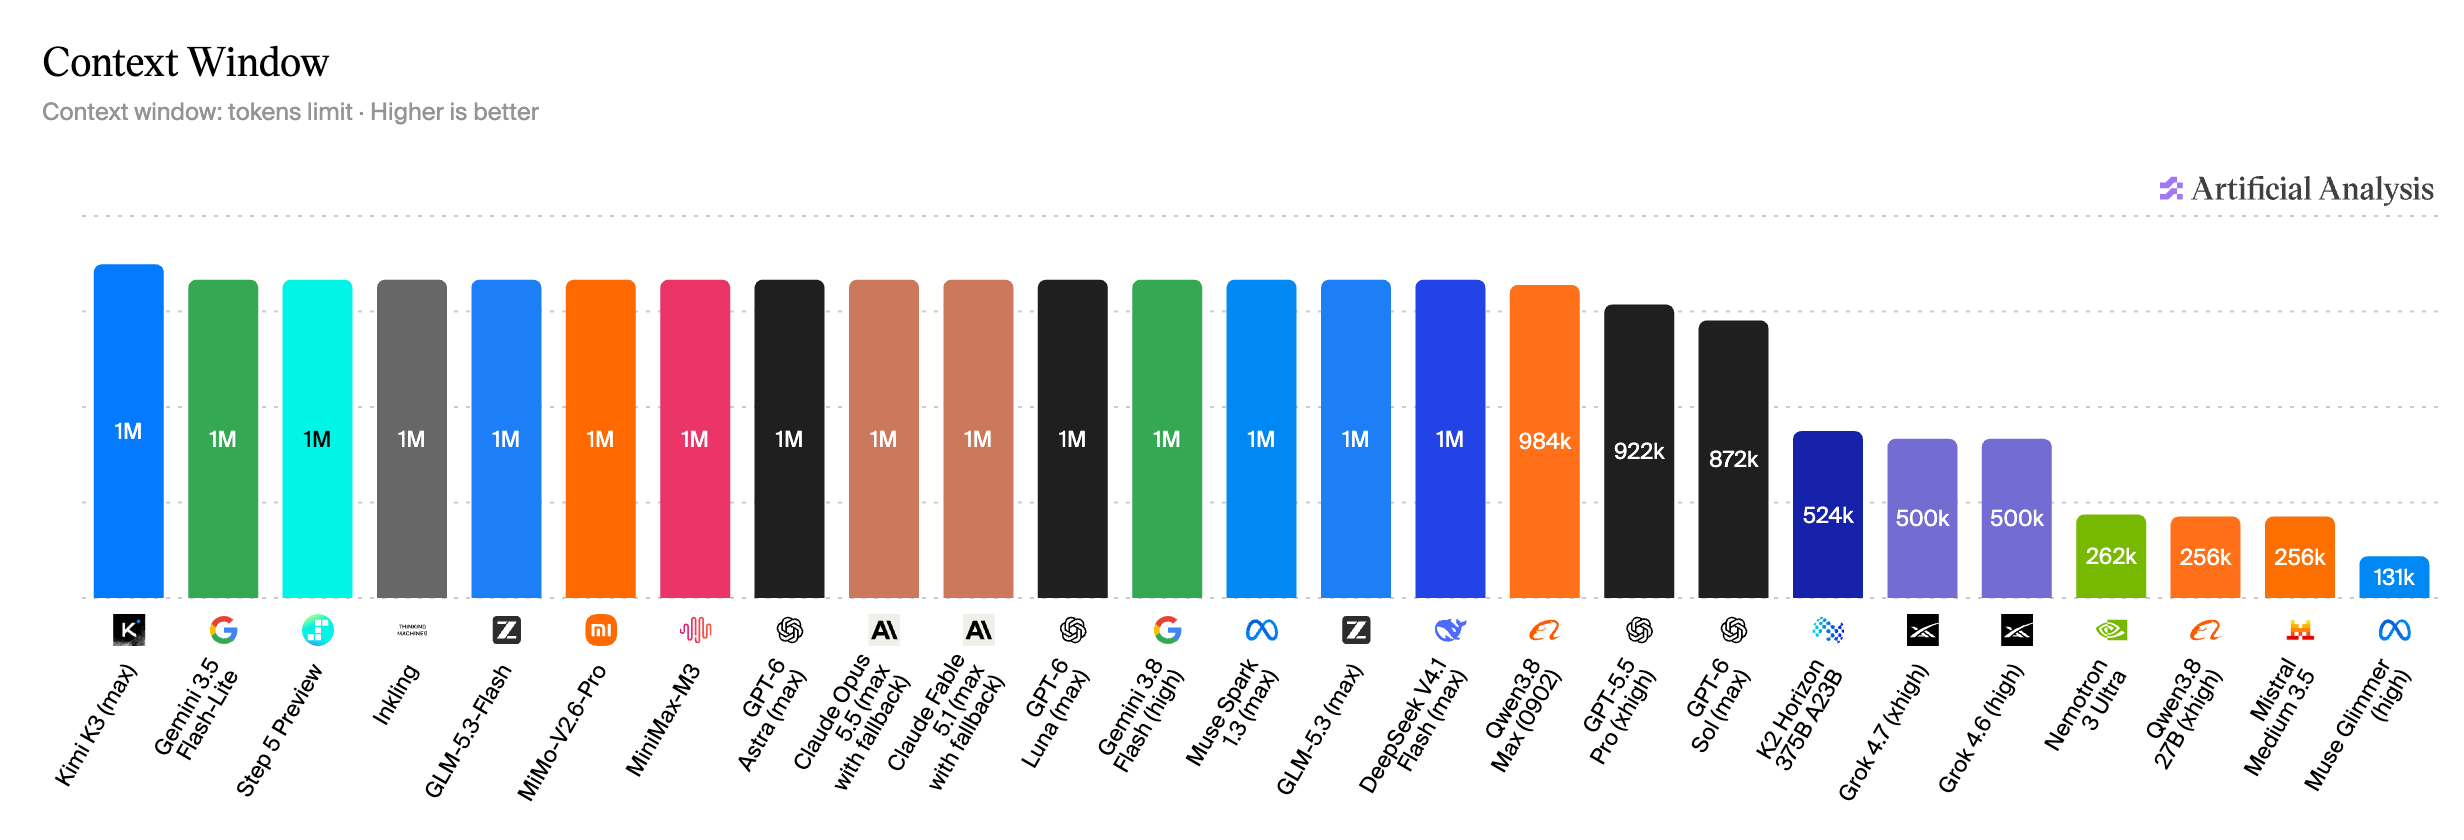
比较可容纳文档、代码与历史对话的上下文空间。
图表解读
本组许多模型的上下文约为 1M Token;图中 Grok 4.7 为 500k,Mistral Medium 3.5 为 256k。
输出速度
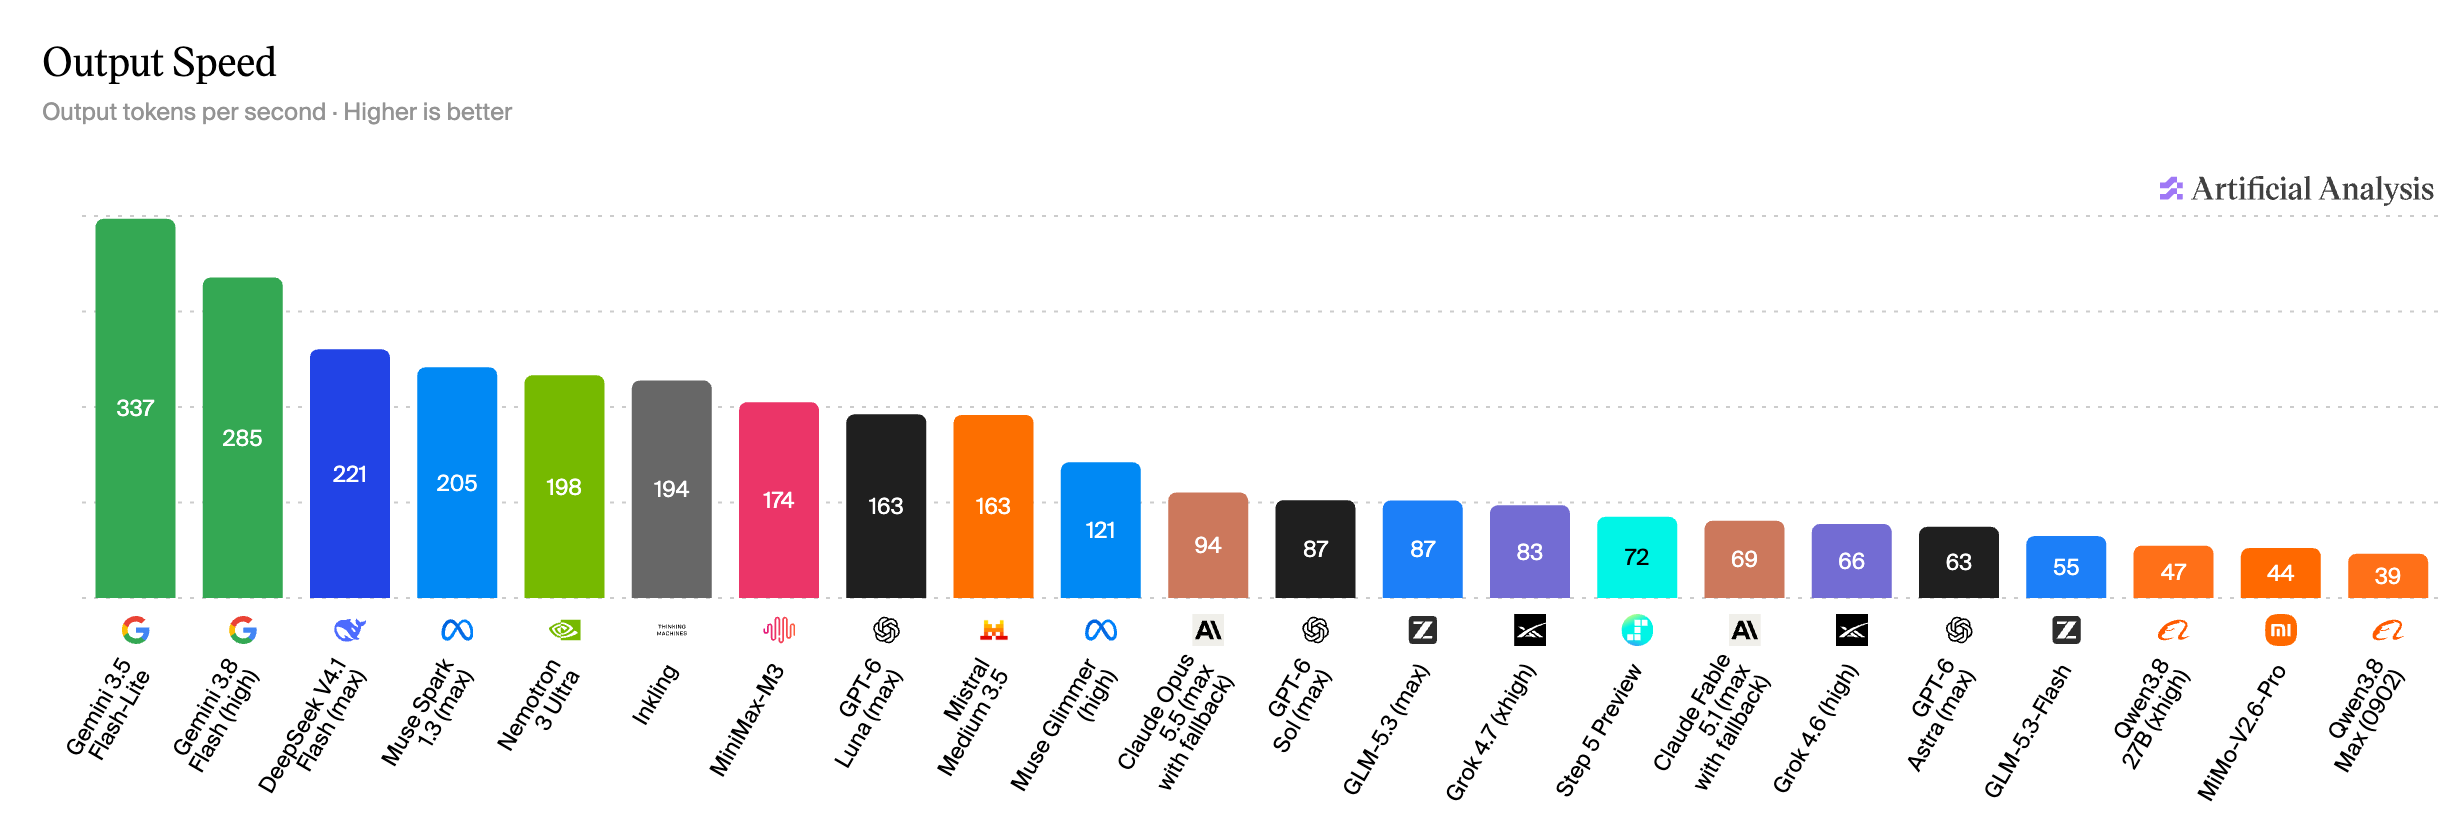
比较开始生成后,文本持续输出的速度。
图表解读
本组 Gemini 3.5 Flash-Lite 达到 337 Token/秒,high 档位的 Gemini 3.8 Flash 为 285 Token/秒。更高输出速度有利于长答案的持续生成。
首答案延迟
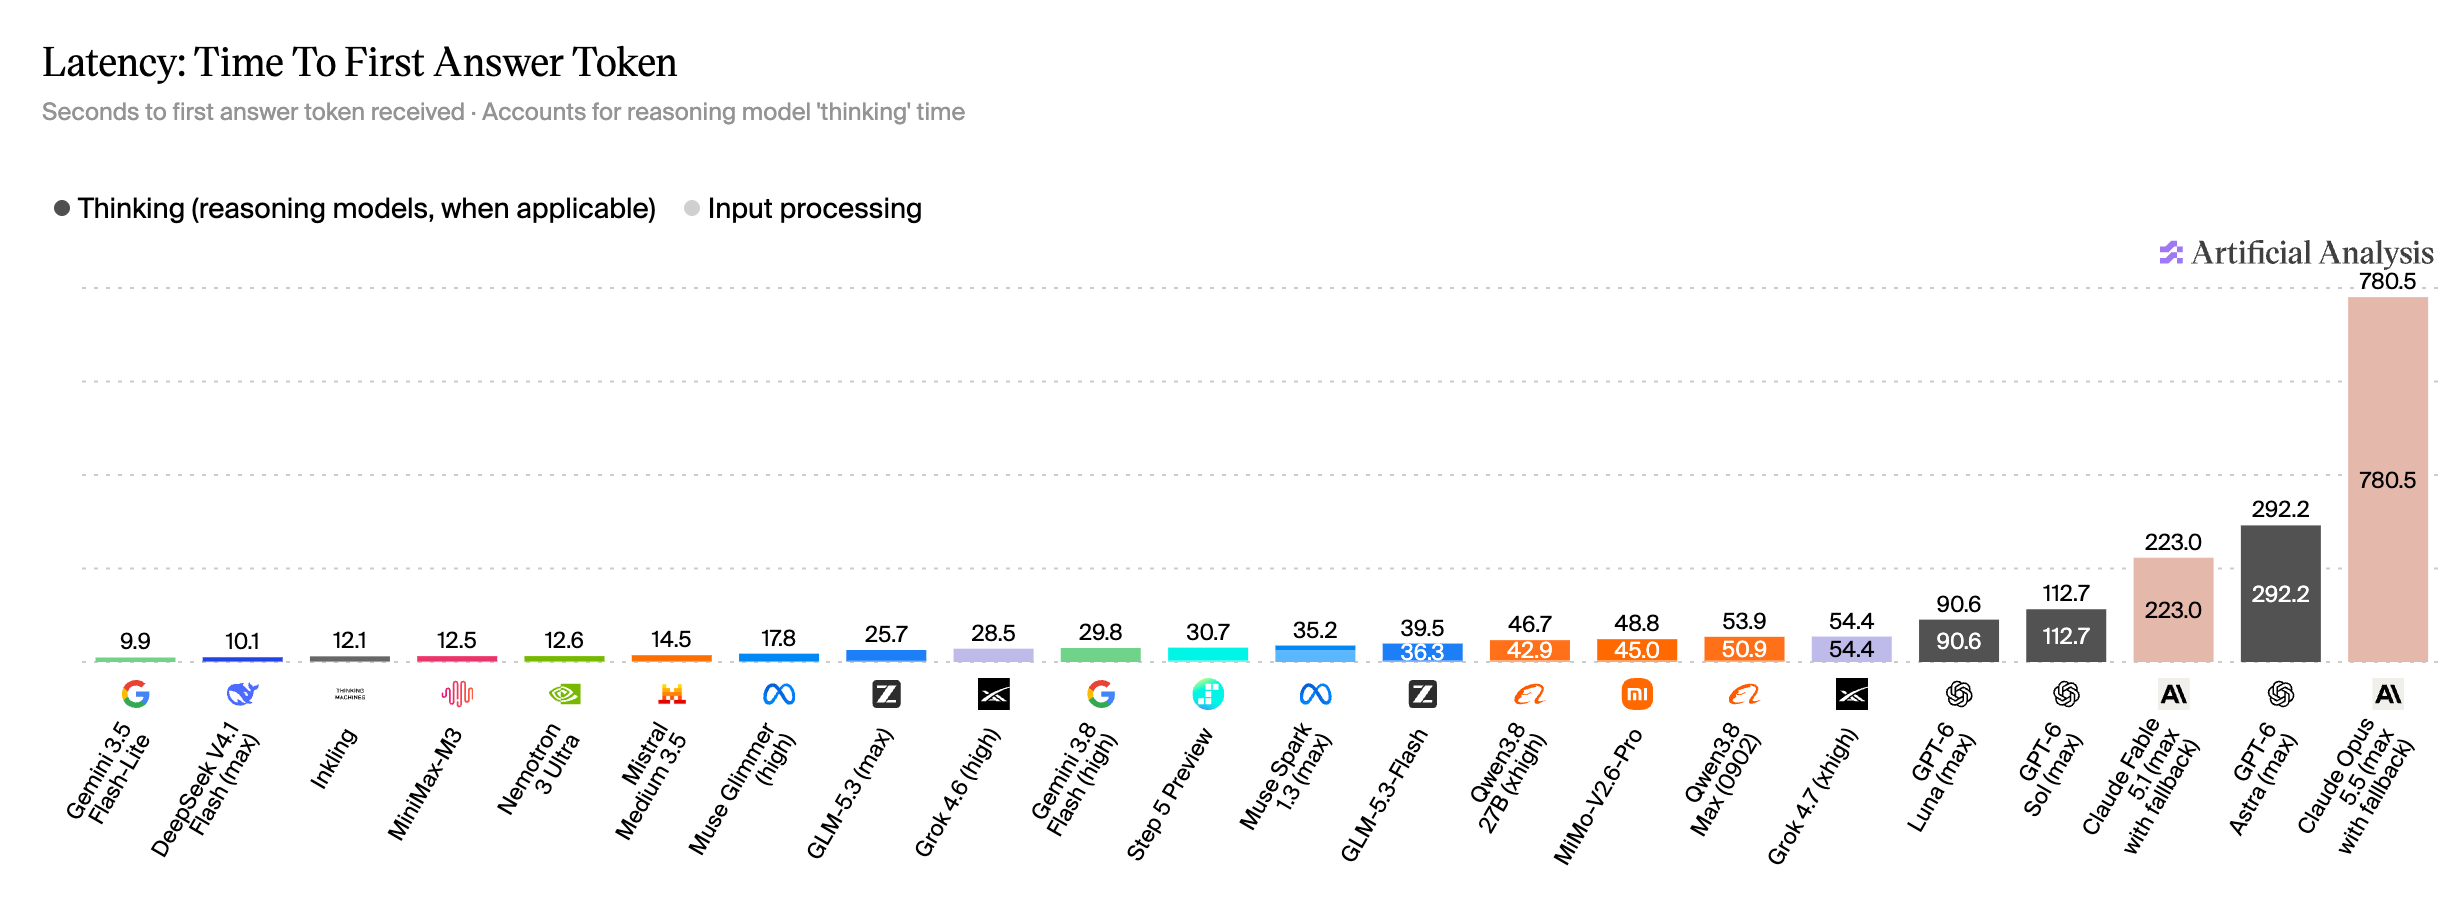
了解用户收到第一个答案 Token 前需要等待多久。
图表解读
图中 xhigh 档位的 Grok 4.7 为 54.4 秒,max 档位的 GPT-6 Astra 为 292.2 秒。思考时间可能成为用户等待的主要部分。