モデル能力
総合知能から利用コスト、応答性まで、8 つの観点でモデルを比較します。
総合知能
推論、コーディング、知識業務の総合能力を比較します。
グラフの解説
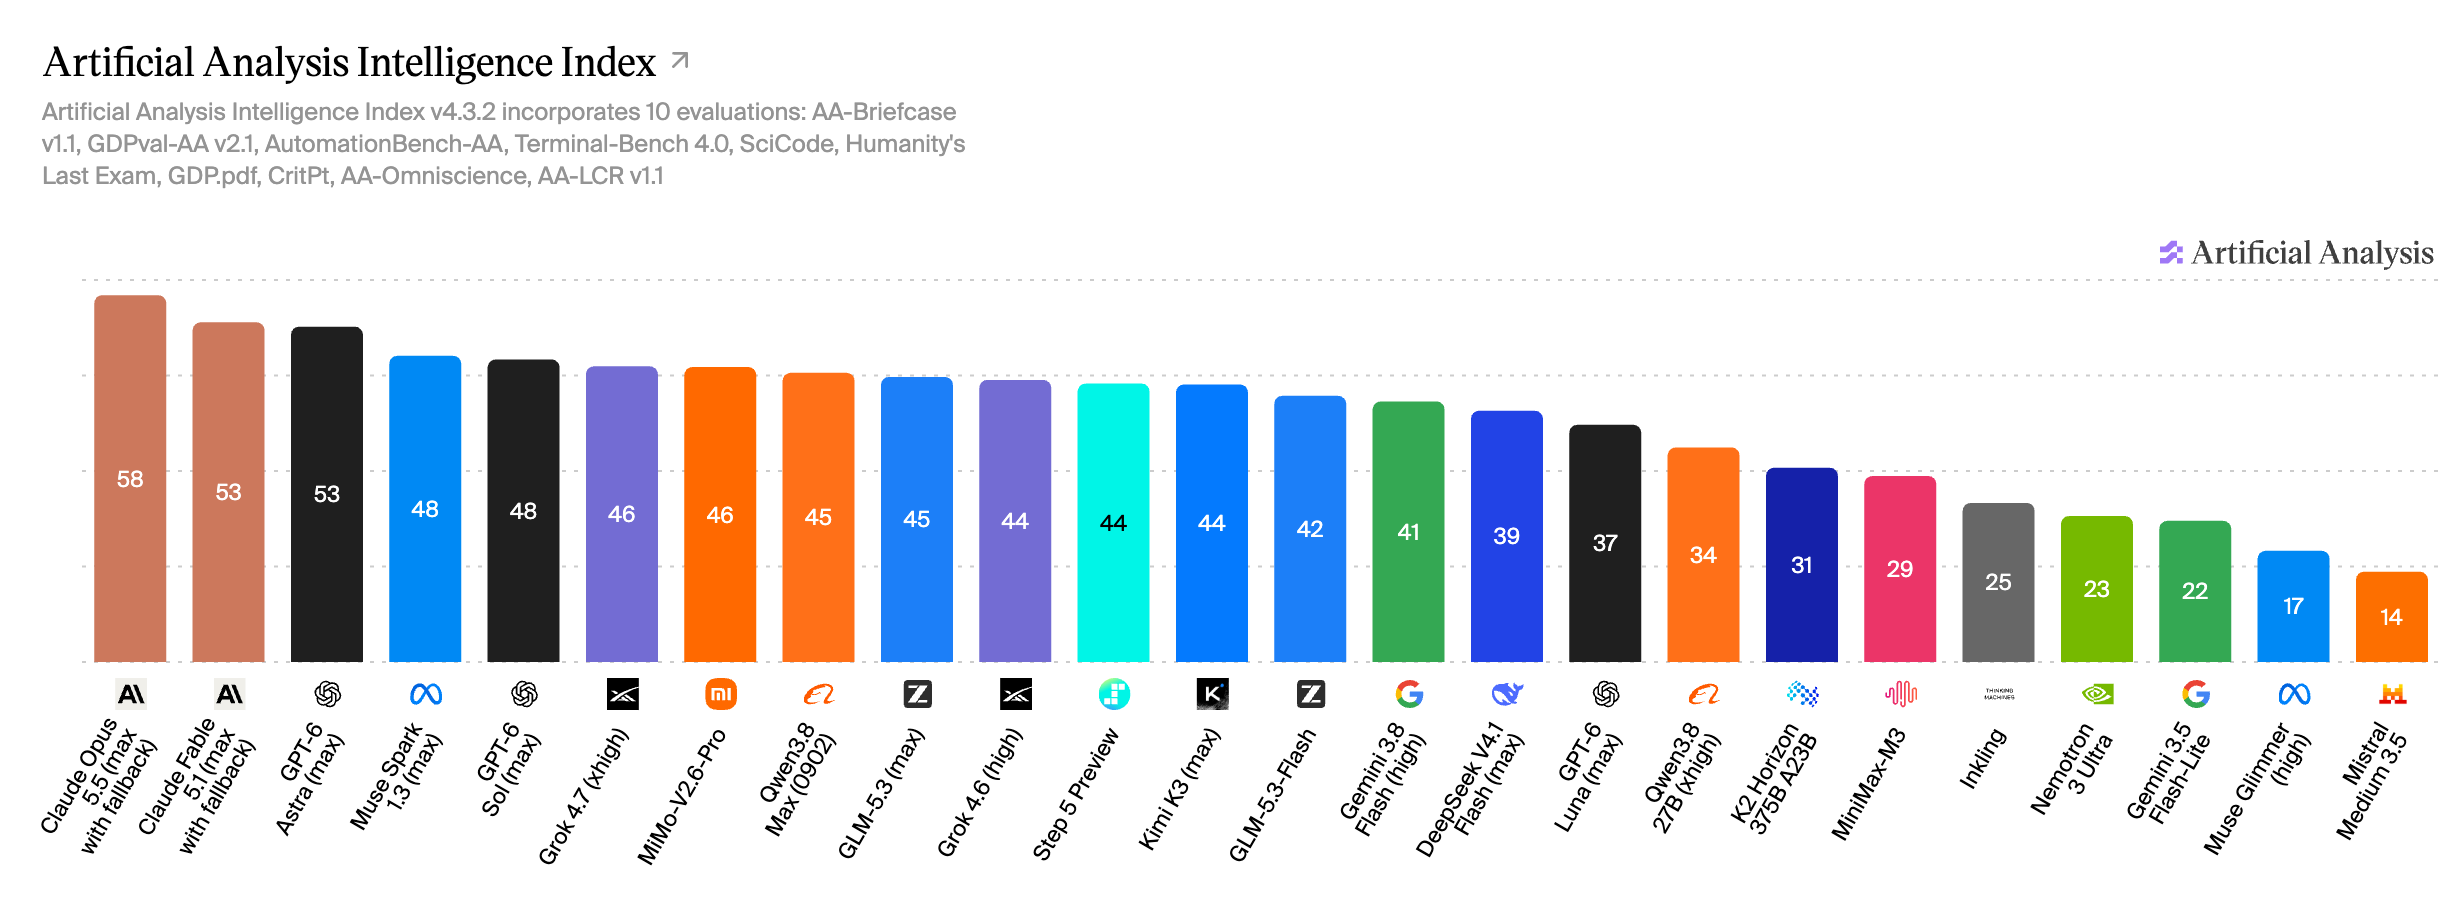
この選択では Opus 5.5 が 58 で先行し、Fable 5.1 と GPT-6 Astra は丸めると 53 です。推論設定も結果の一部です。
分野別評価
コーディング、推論、事実知識、長文脈、視覚推論を個別に確認します。
19 項目の評価グラフを表示19 評価 · 個別の尺度
グラフの解説
首位はタスクによって変わります。コードは Terminal-Bench と SciCode、長文脈推論は AA-LCR、視覚推論は MMMU-Pro を確認します。
知識業務エージェント
複雑な依頼から有用な成果物を作れるかを評価します。
グラフの解説
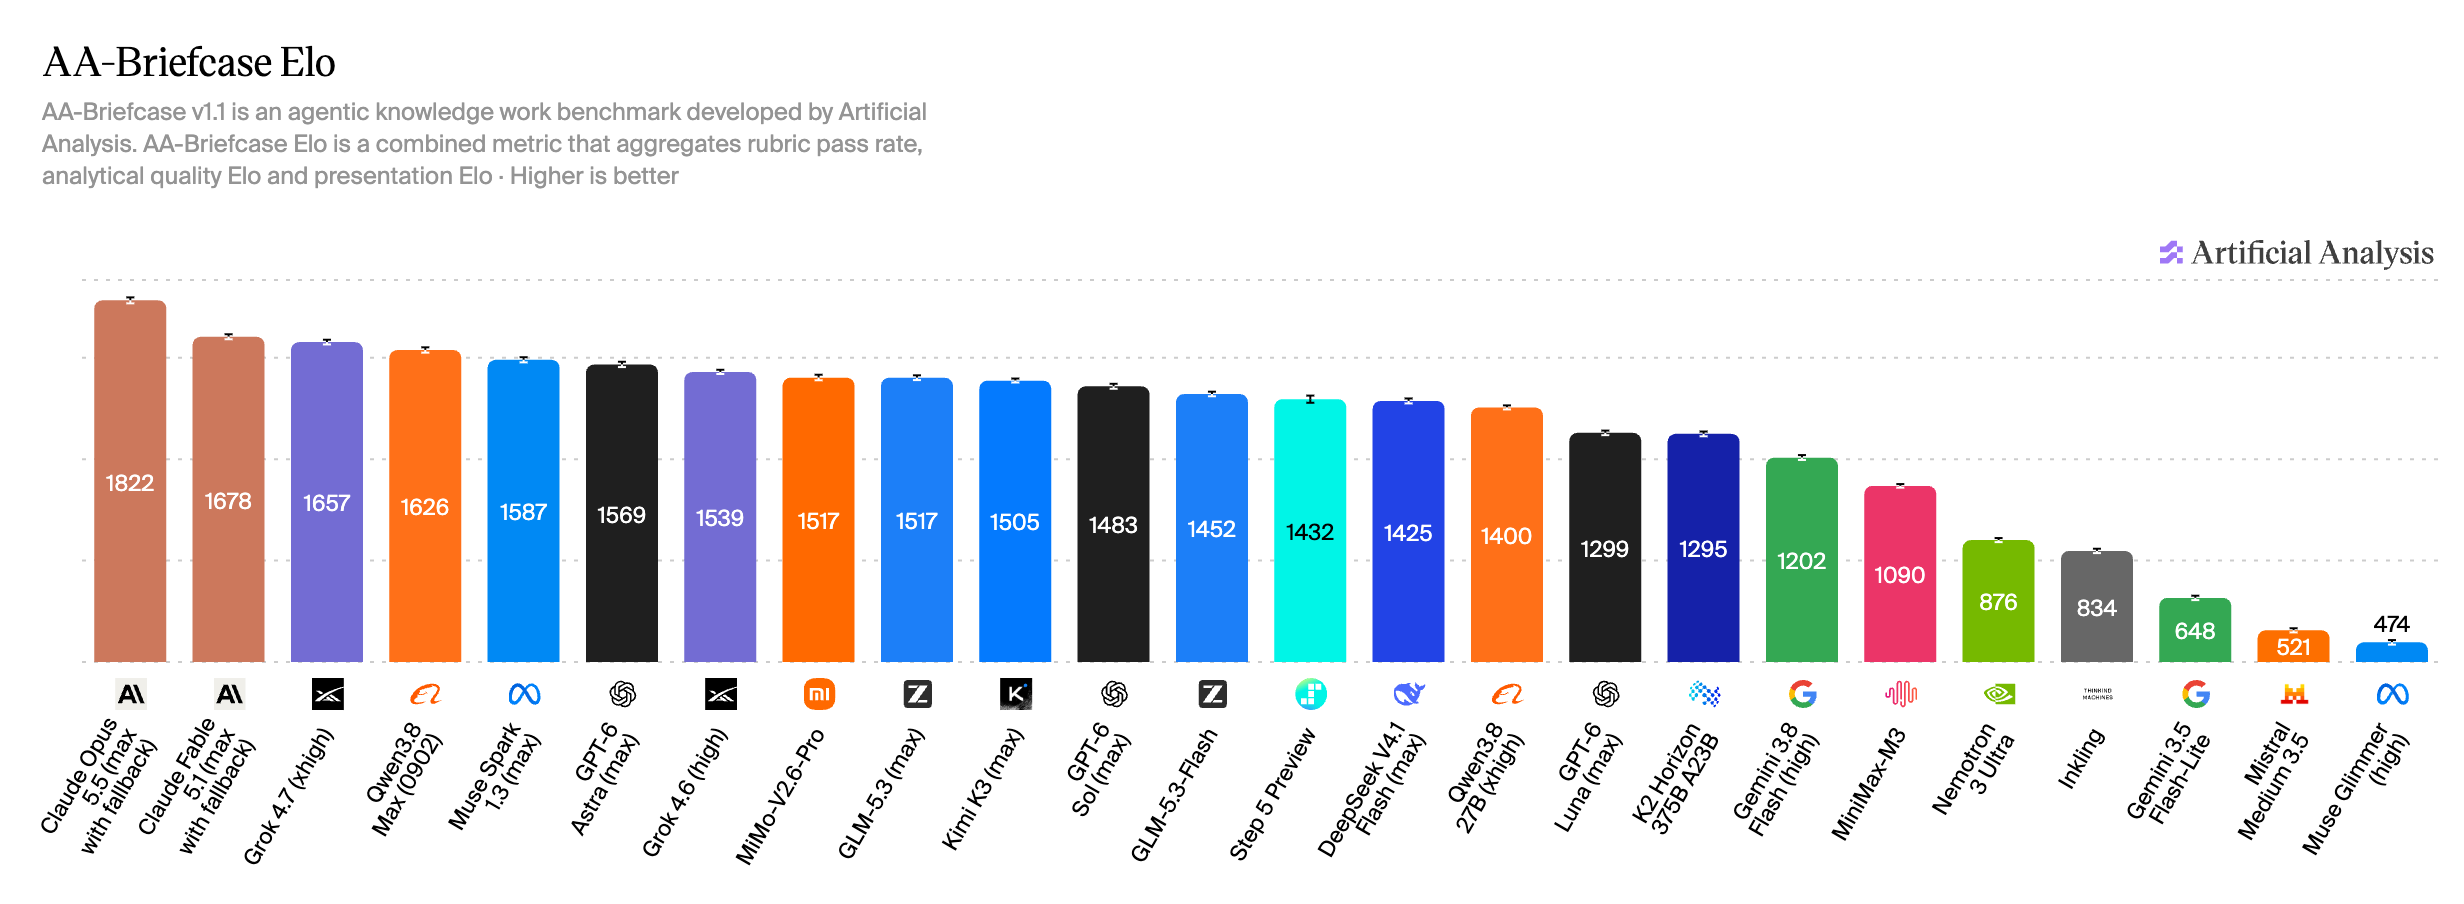
この選択では Opus 5.5 が 1822 Elo、続いて Fable 5.1 が 1678、Grok 4.7 が 1657 です。
能力とコスト
必要な能力と持続可能なタスク単価のバランスを探します。
グラフの解説
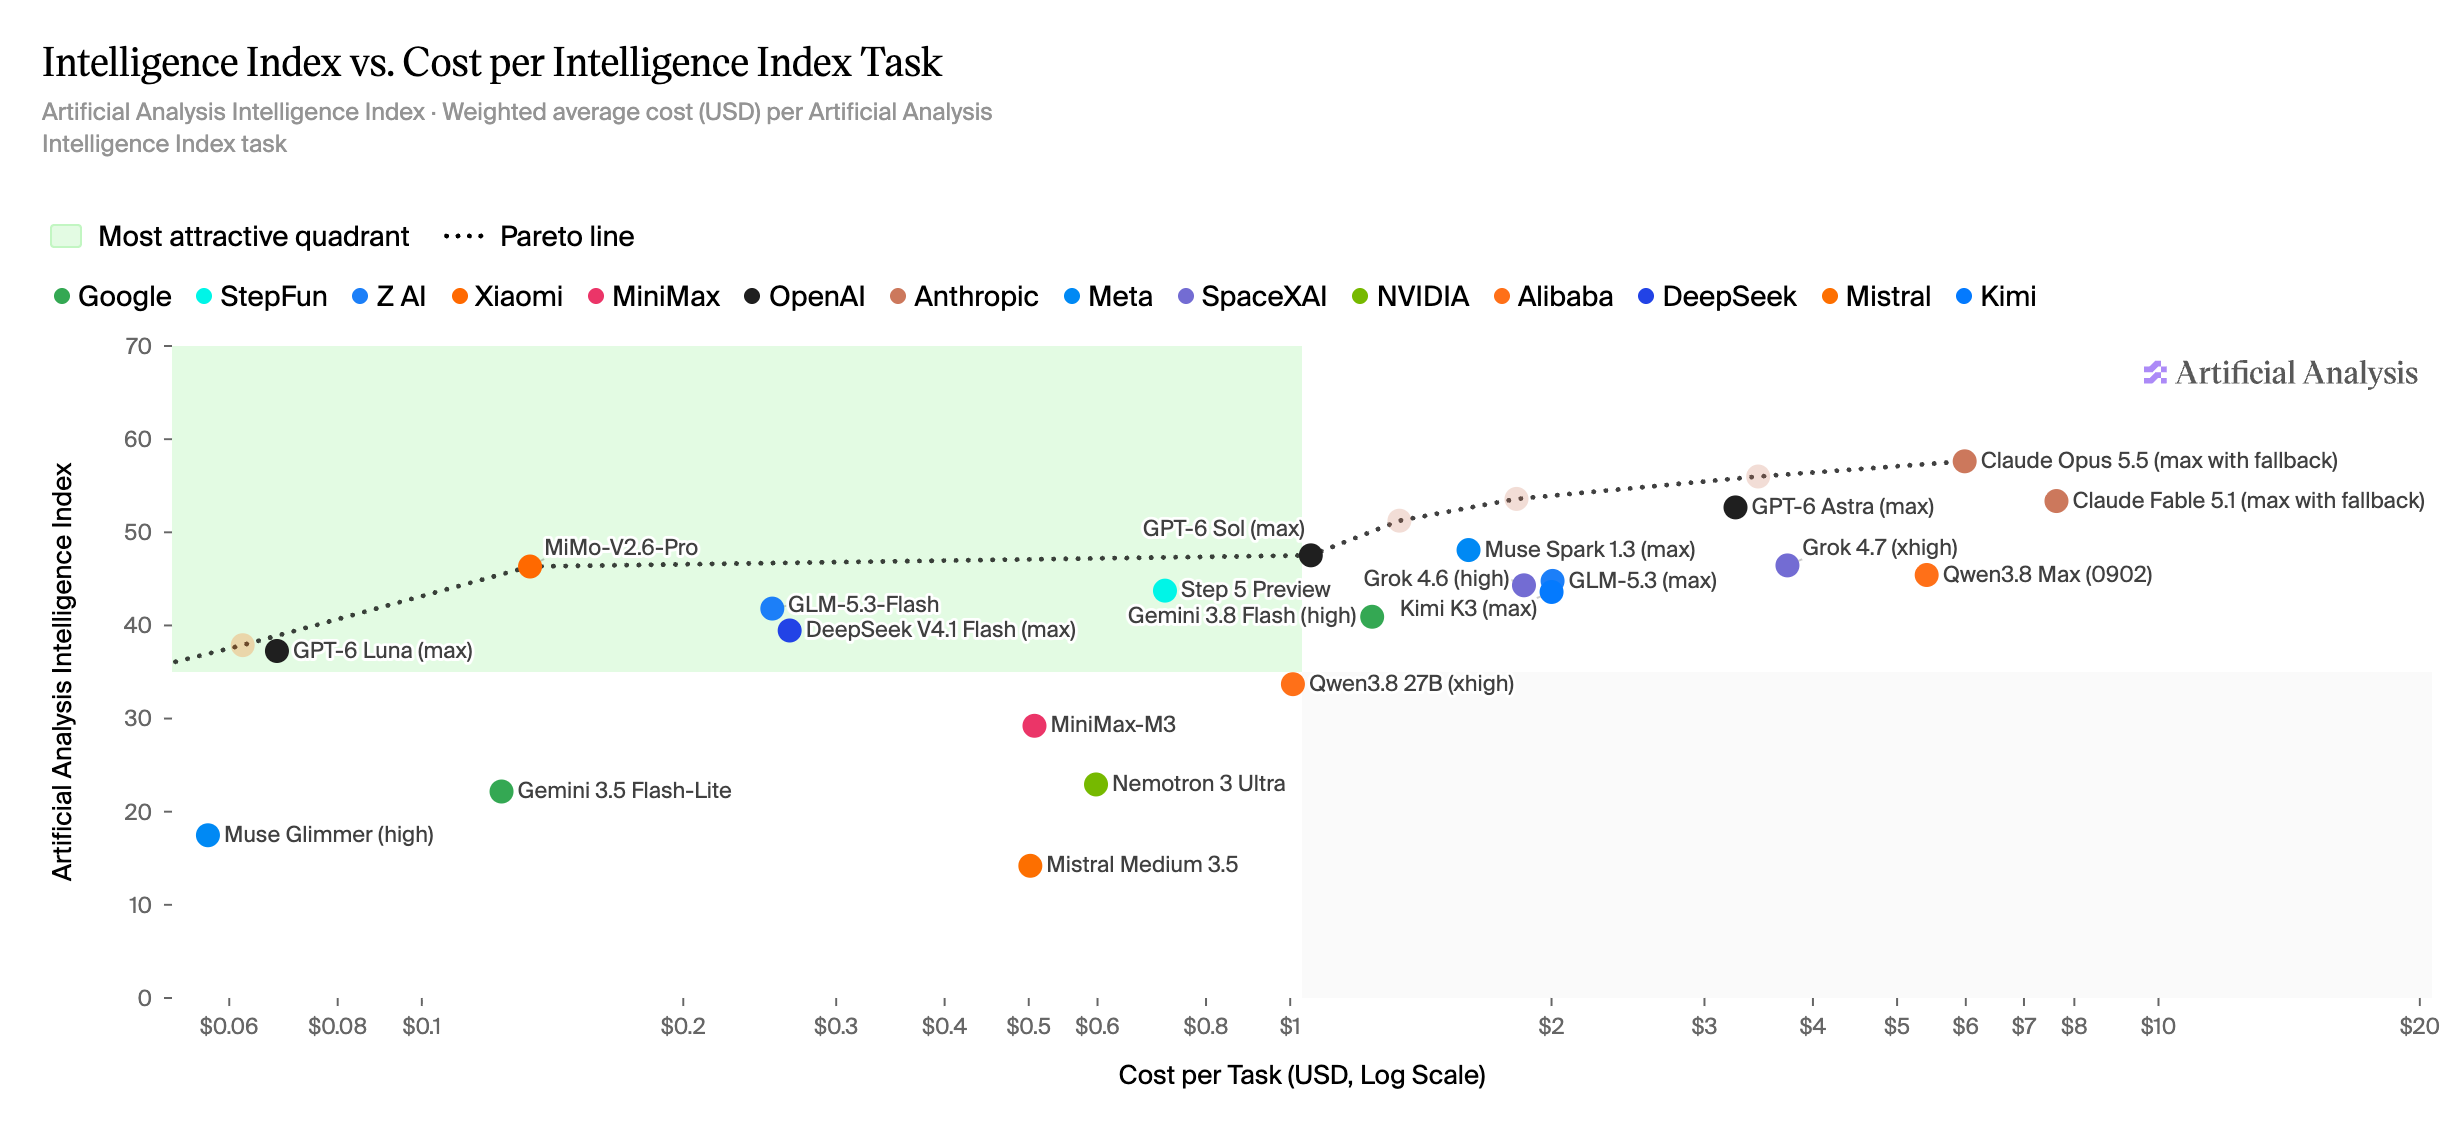
左上ほど高能力・低コストです。点線のフロンティアは、この選択内で効率的な候補を見つける目安です。
トークン効率
評価タスクで消費する推論と回答のトークン数を確認します。
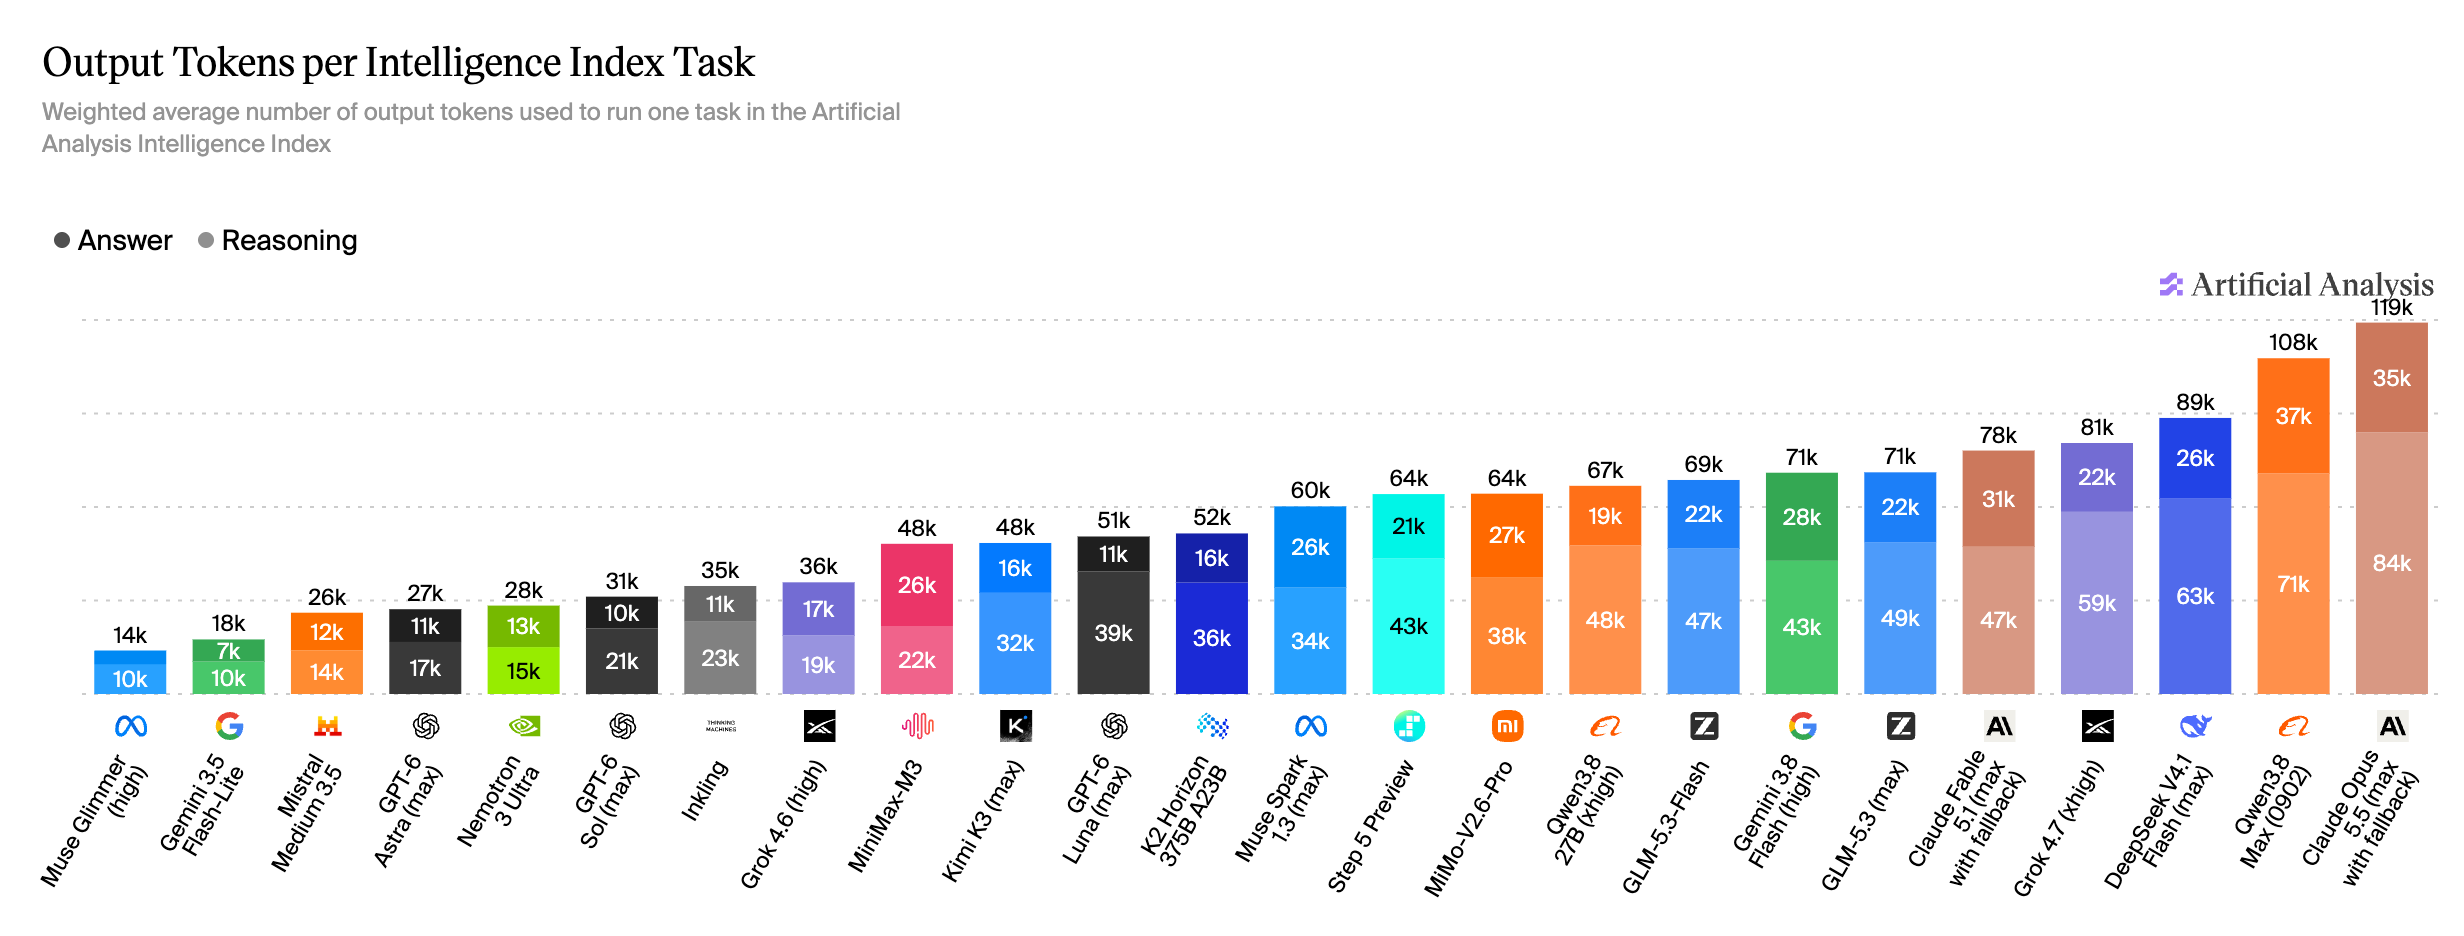
グラフの解説
Opus 5.5 は 1 タスク約 119k 出力トークン、GPT-6 Sol は約 31k です。推論トークンが大きな割合を占めます。
コンテキスト容量
文書、コード、会話履歴を収める容量を比較します。
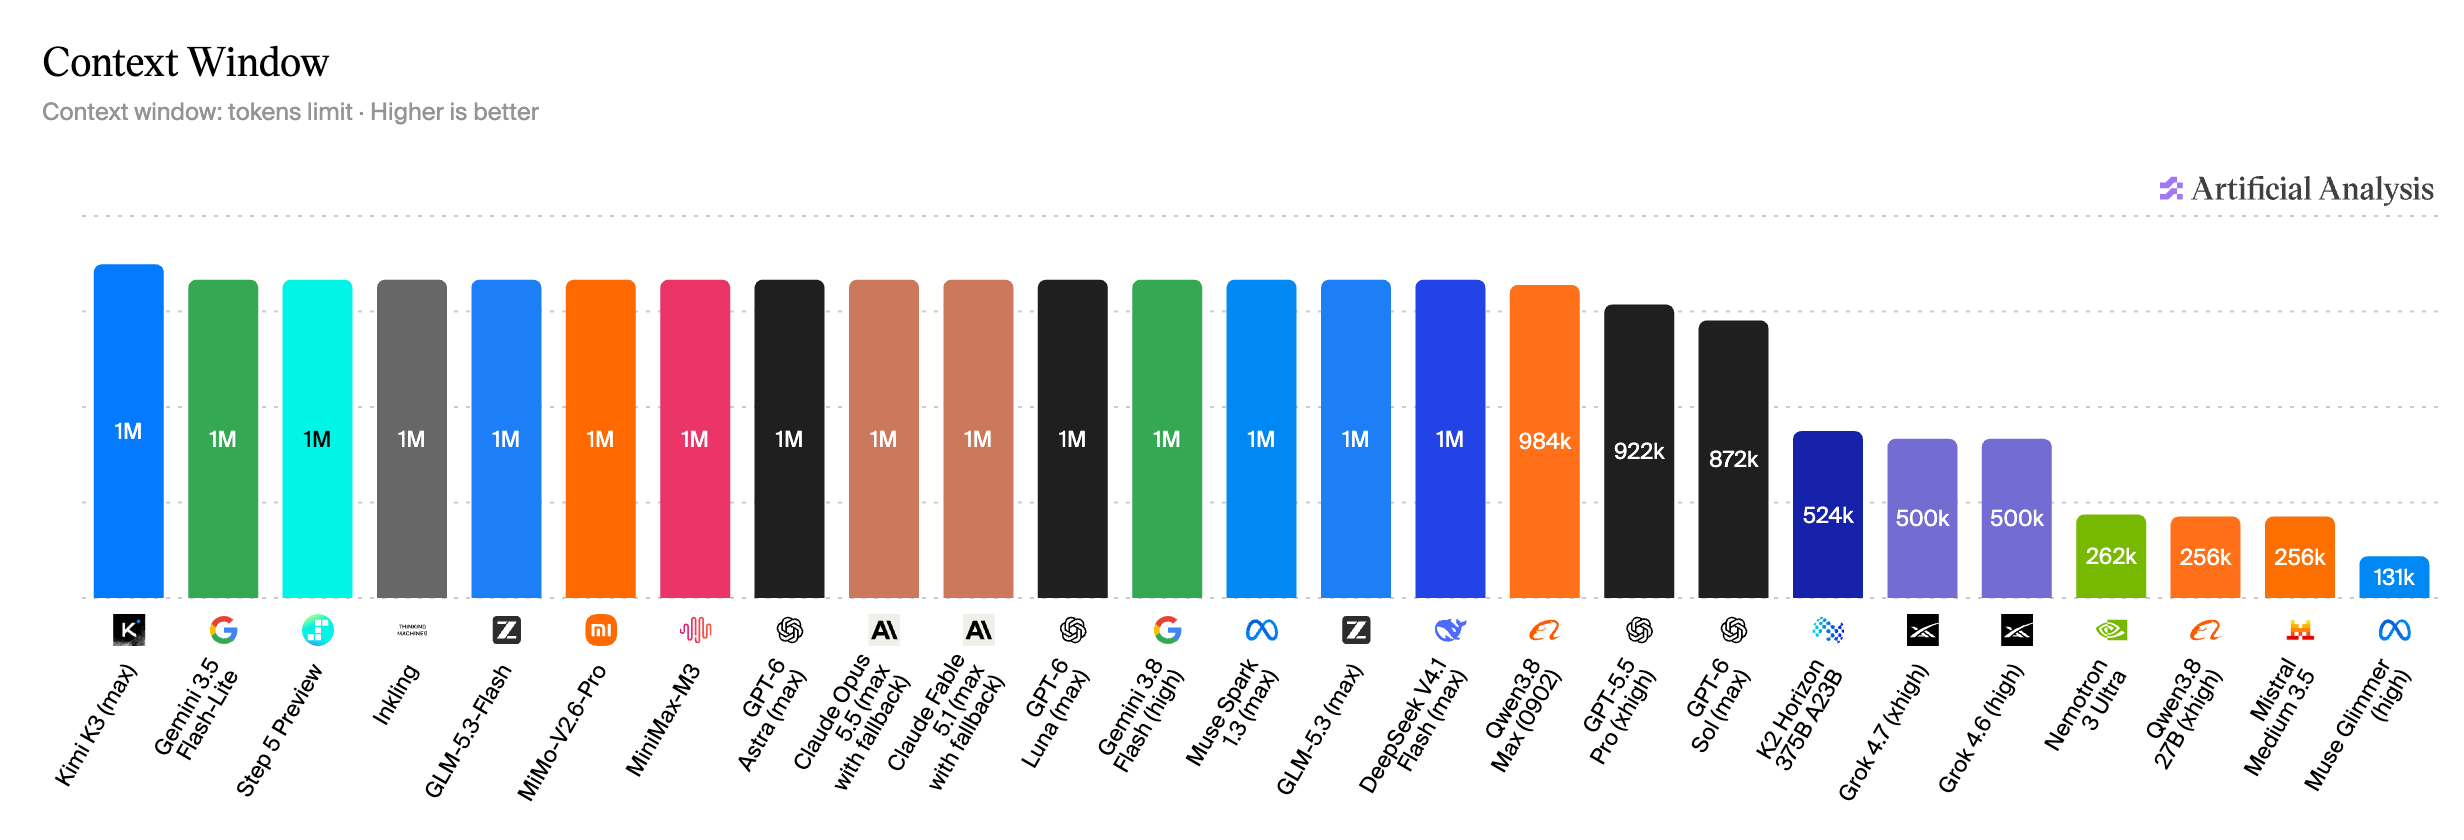
グラフの解説
この選択の多くは約 1M トークンの文脈に対応し、Grok 4.7 は 500k、Mistral Medium 3.5 は 256k と表示されています。
出力速度
生成開始後にテキストが届く速度を比較します。
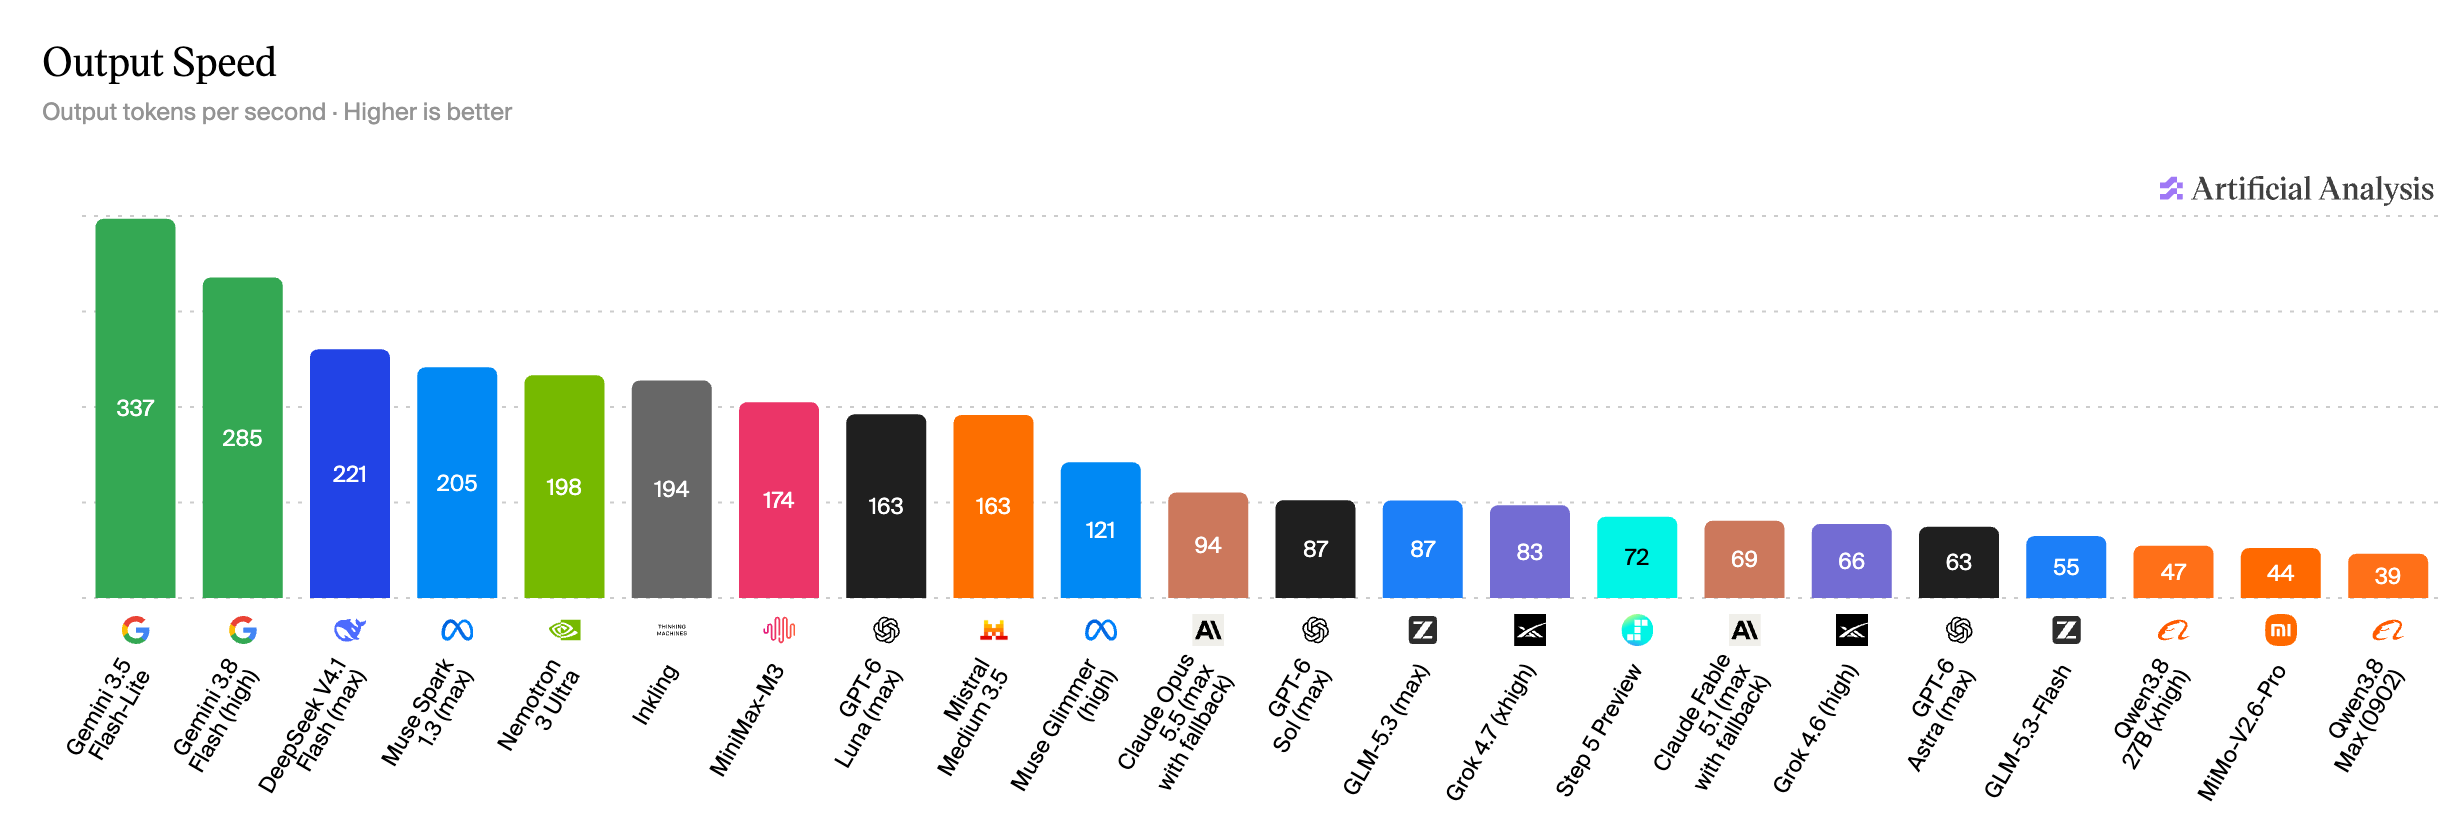
グラフの解説
この選択では Gemini 3.5 Flash-Lite が 337 トークン/秒、high 設定の Gemini 3.8 Flash が 285 トークン/秒です。高速出力は長い回答に有利です。
最初の回答までの時間
最初の回答トークンを受け取るまでの待ち時間を確認します。
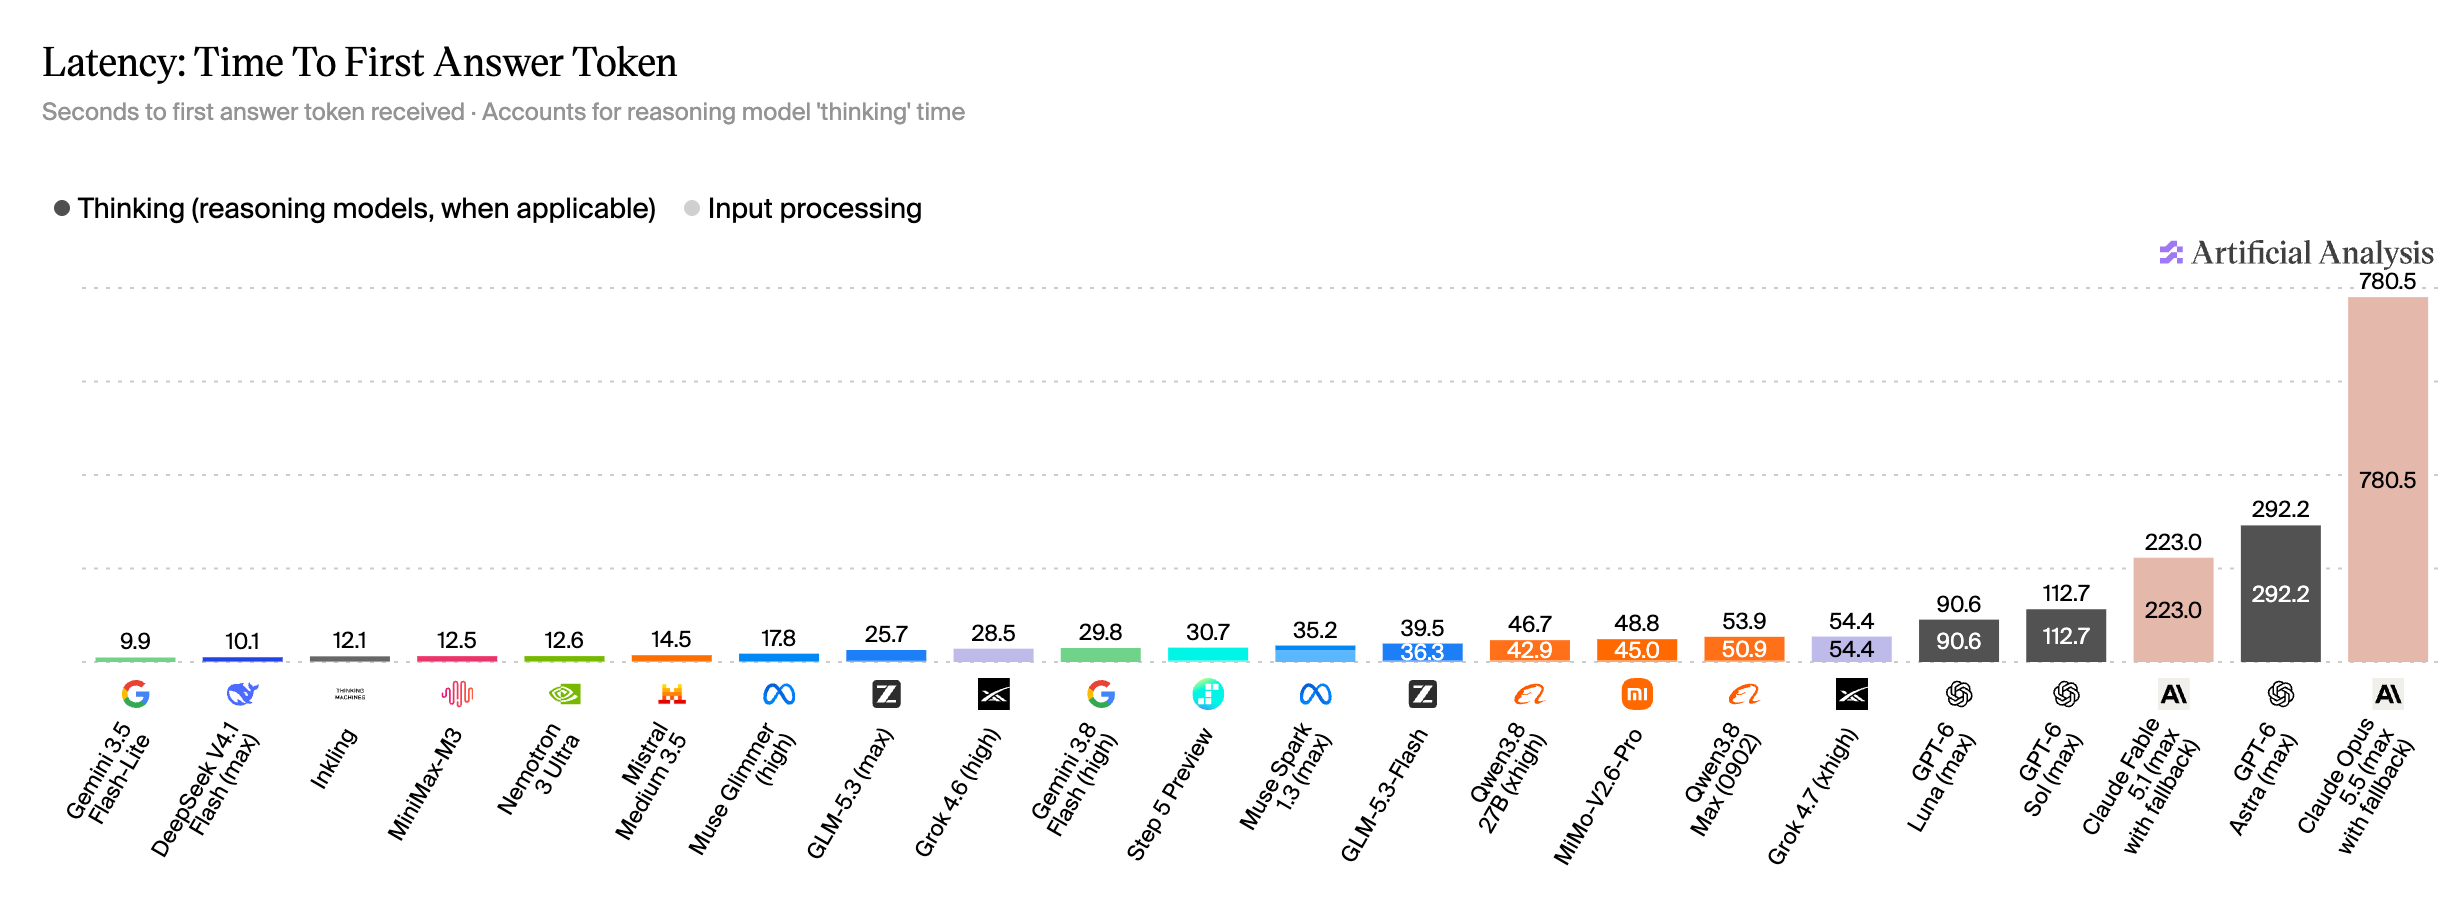
グラフの解説
xhigh 設定の Grok 4.7 は 54.4 秒、max 設定の GPT-6 Astra は 292.2 秒です。思考時間が待ち時間の大半を占める場合があります。